ทำไมตัวอักษรไทยบนเว็บหรือ e-reader ถึงตัดอักษรผิด
Read this article in English: Why Thai Text on the Web or E-Readers Splits Characters Wrong
บทความแรกของบล็อกนี้เขียนเป็นภาษาไทย จนกระทั่งมีคนทักมาว่า “อ่านบนมือถือแล้วตัวอักษรมันขาดๆ” ผมถึงได้รู้ว่าเว็บของตัวเองมีปัญหาการตัดคำภาษาไทยที่ไม่เคยสังเกตมาก่อน บทความนี้คือบันทึกการแก้ไขทั้งหมด ตั้งแต่จุดที่คิดผิดในตอนแรก ไปจนถึงคำตอบจริง และสิ่งที่เรียนรู้ระหว่างทางว่าเป็นเรื่องใหญ่กว่าที่คิดไว้มาก ทั้งเรื่อง Thai word tokenizer หลายตัวที่ไม่เห็นตรงกันด้วยซ้ำว่า “คำ” คืออะไร ไปจนถึงว่าภาษาอื่นที่เป็นระบบ Abugida (อักษรสระประกอบ; ระบบการเขียนรูปแบบหนึ่งที่พยัญชนะแต่ละตัวจะมีสระติดมาด้วย) และ Scriptio Continua (ระบบการเขียนที่ไม่มีการเว้นวรรค) เช่น ภาษาลาว, ภาษาเขมร, ภาษาพม่า, ภาษาทิเบต เป็นต้น แก้ปัญหานี้กันอย่างไรบ้าง
อาการ: ตัวอักษรที่ “โดนตัด” ไปกลางคำ
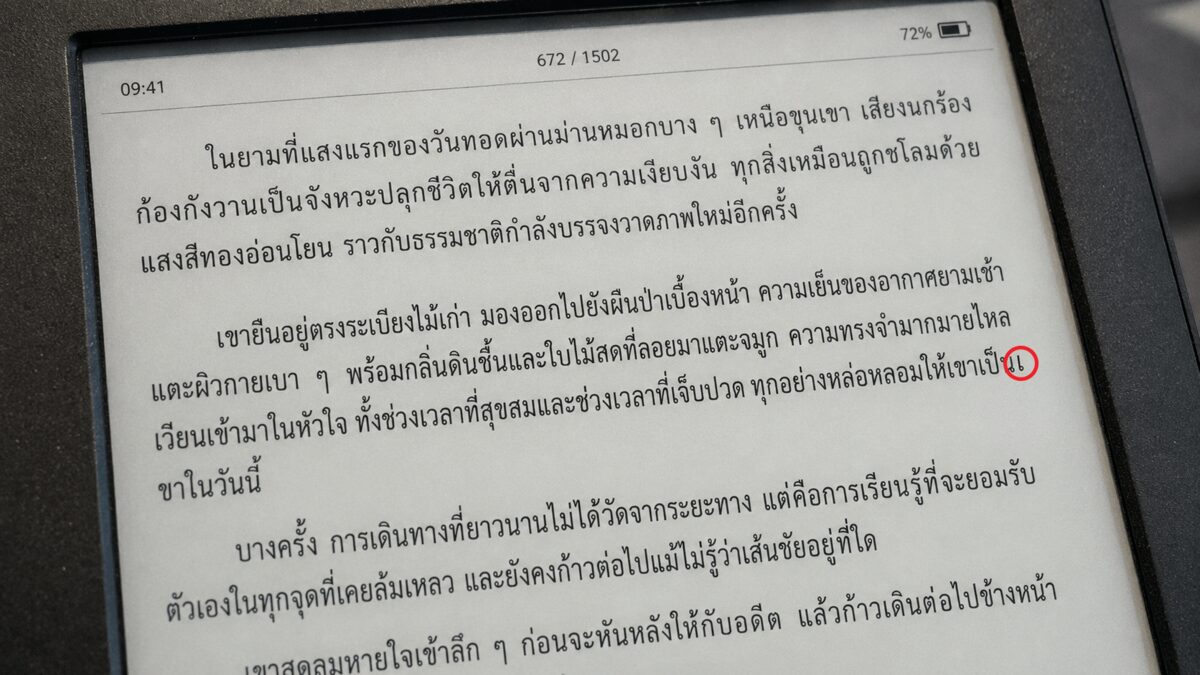
เรื่องเกิดจากมีผู้อ่านส่ง screenshot มาสองภาพ ภาพแรกจาก LINE in-app browser บนมือถือ ส่วนภาพที่สองคือบทความที่ export จาก Safari mobile เป็น PDF ทั้งสองภาพแสดงย่อหน้าเปิดของบทความหนึ่ง และคำว่า “เตรียม” ถูกตัดกลางคำจนเหลือ “เ” ตัวเดียวลอยอยู่ท้ายบรรทัด แล้วส่วนที่เหลือ “ตรียม” ก็ไปขึ้นบรรทัดใหม่
ปัญหาที่เจอ
ทั้งสอง screenshot มาจากมือถือ แต่ บนคอมพิวเตอร์ของผมเอง เปิดหน้าเดียวกันใน Chrome แล้วไม่เจอปัญหานี้เลย ข้อความถูกตัดสวยงามปกติทุกอย่าง
นี่คือจุดเริ่มต้นของการหาคำตอบทั้งหมด: ทำไมหน้าเดียวกัน เนื้อหาเดียวกัน ถึง render ต่างกันขนาดนี้ระหว่างเครื่อง
สมมติฐานแรก (ที่ผิด)
“WebKit ไม่รองรับการตัดคำภาษาไทย”
สมมติฐานแรกคือ Safari/WebKit ในสภาพแวดล้อมที่เกิดปัญหาอาจไม่มีระบบแบ่งคำไทยเหมือน Chrome แต่ screenshot เพียงอย่างเดียวยังยืนยันรายละเอียดภายในของ browser ไม่ได้
สมมติฐานนี้ไม่สอดคล้องกับผลที่ผมทดสอบ BBC Thai ด้วย WebKit ของ Playwright: ย่อหน้าภาษาไทยที่ลอง wrap ได้ตามปกติ อย่างไรก็ตาม WebKit ของ Playwright ไม่ใช่ build เดียวกับ iOS Safari หรือ LINE ที่สร้าง screenshot ต้นเรื่อง จึงใช้เป็นข้อมูลเปรียบเทียบ ไม่ใช่หลักฐานแทนทุกสภาพแวดล้อม
ผมเลยลองทำการ Controlled test โดยสร้างหน้า HTML เปล่าๆ ใส่ย่อหน้าภาษาไทยเดียวกัน 5 ชุด แต่ละชุดใช้ CSS word-break/overflow-wrap คนละแบบ แล้ว render ทั้ง 5 ชุดด้วย WebKit ตัวเดียวกัน เทียบกัน:
| CSS ที่ใช้ | ผลใน WebKit ที่ทดสอบครั้งแรก |
|---|---|
| ไม่ตั้งค่าอะไรเลย (browser default) | wrap ถูก ไม่มีคำขาด |
overflow-wrap: break-word อย่างเดียว |
wrap ถูก |
word-break: break-word (legacy) |
wrap ถูก |
word-break: normal; overflow-wrap: normal; |
wrap ถูก |
word-break: keep-all + overflow-wrap: break-word (ค่าที่เว็บผมใช้อยู่ ณ ตอนนั้น) |
มีคำขาดกลางคำ |
สาเหตุที่แท้จริง
มันคือ Bug ที่ผมสร้างเอง
เว็บผมเคยตั้ง CSS เพื่อพยายามแก้ปัญหาอักษรไทยนี้มาก่อนในอดีต แต่กลายเป็นทำให้ปัญหาแย่ลงกว่าค่า default ของ browser อีก
/* ก่อนแก้ */
.markdown-body[lang="th"] {
  line-height: 1.8;
  word-break: keep-all;
  overflow-wrap: break-word;
}
ผลทดสอบเดิมแยกได้ว่าชุด word-break: keep-all ร่วมกับ overflow-wrap: break-word สัมพันธ์กับการ wrap ที่มีปัญหา และการลบ keep-all แก้กรณีนั้นได้ แต่ ข้อกำหนด CSS Text ระบุให้คงจุดตัดที่ได้จาก dictionary ไว้ภายใต้ keep-all ไม่ได้กำหนดให้ปิดการแบ่งคำไทย ดังนั้นควรเรียกสิ่งที่พบว่าเป็นพฤติกรรมเฉพาะ implementation ในสภาพแวดล้อมที่ทดสอบ ไม่ใช่ความหมายที่ CSS ตั้งใจให้เป็น ภาพที่เห็นยังพิสูจน์ไม่ได้ว่ากลไกภายในส่วนไหนล้มเหลว ส่วน overflow-wrap: break-word อนุญาตให้ตัดฉุกเฉินเมื่อข้อความที่ตัดไม่ได้จะล้นบรรทัด ซึ่งสอดคล้องกับอาการที่รายงาน
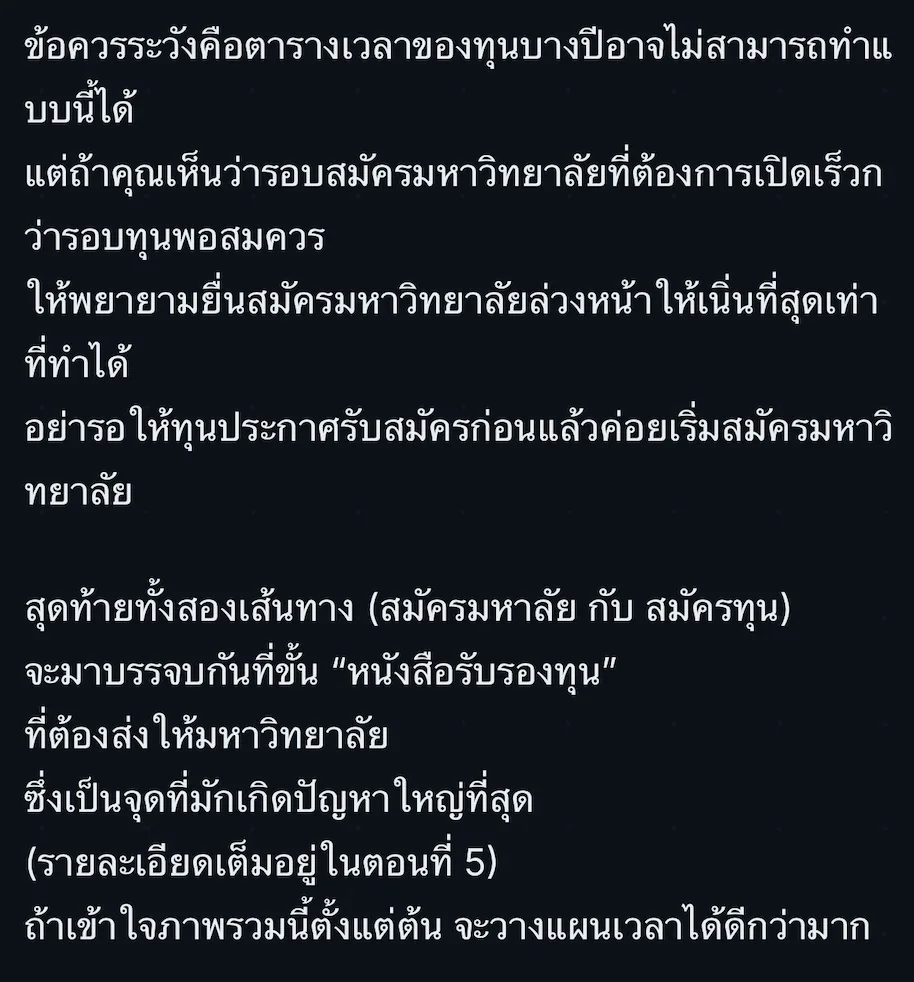 ตัวอย่างจริงจากบทความอื่นบนเว็บนี้ ก่อนแก้บั๊ก
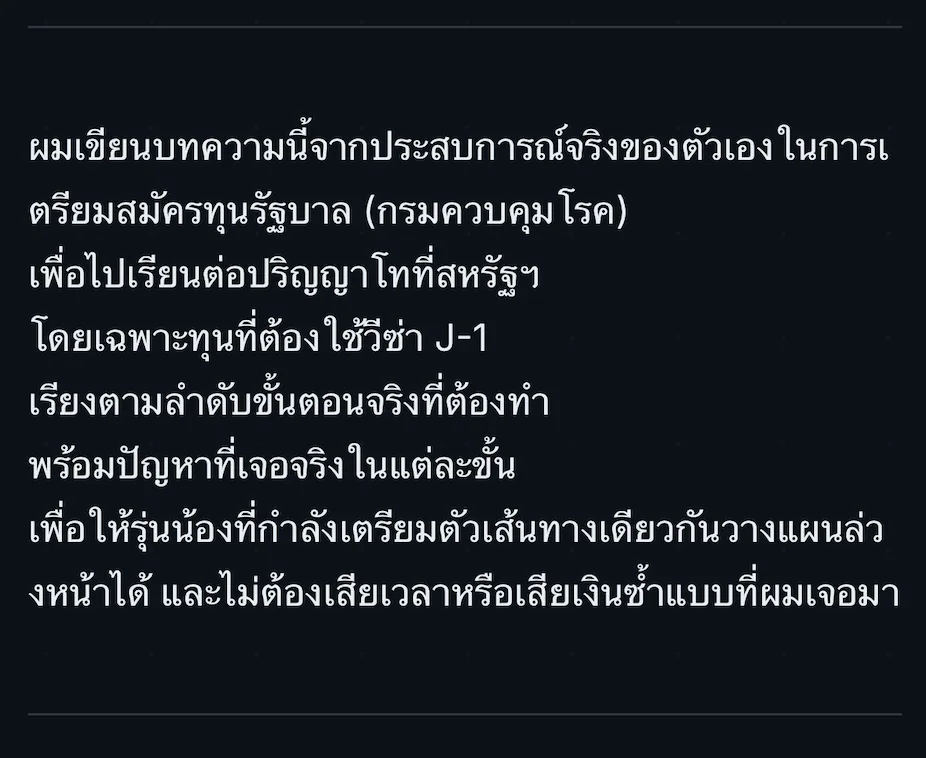 ย่อหน้าเปิดของบทความเดียวกัน คำถูกตัดกลางคำตั้งแต่บรรทัดแรก
ทางแก้คือลบบรรทัดเดียว:
  .markdown-body[lang="th"] {
    line-height: 1.8;
-   word-break: keep-all;
    overflow-wrap: break-word;
  }
ในการทดสอบซ้ำครั้งเดิมด้วย WebKit ของ Playwright คำที่เคยขาด (เตรียม → เ + ตรียม) กลับมาอยู่ด้วยกัน และกรณีที่ลองใน Chrome ยัง wrap ได้ตามปกติ นี่เป็นหลักฐานสนับสนุน workaround สำหรับกรณีที่ทดสอบ ไม่ใช่การรับประกันทุก browser version, font และความกว้างหน้าจอ
สิ่งที่เหลือ: จุดแบ่งคำที่ควรตรวจใน layout จริง
การแก้ CSS ช่วยกรณีที่รายงาน ส่วนการวิเคราะห์เดิมใช้บทความเกี่ยวกับทุน/วีซ่าความยาว 35,436 ตัวอักษร บันทึกตอนนั้นระบุ candidate 70 คำจาก token ที่ไม่ซ้ำกัน 934 รายการ ซึ่งมีขอบเขตต่างจากผลของ Intl.Segmenter ตัวเลขนี้เป็นผลใน input และสภาพแวดล้อมครั้งนั้น ไม่ใช่จำนวนข้อผิดพลาดในการ render ที่ยืนยันแล้ว ตัวอย่างที่พบ ได้แก่:
- ตัวเอง คำสรรพนามที่ใช้บ่อยมาก ถูกตัดเป็น ตัว + เอง
- ขั้นตอน คำที่ใช้ทุกหัวข้อ ถูกตัดเป็น ขั้น + ตอน
- เจ้าหน้าที่, สถานทูต, พาสปอร์ต, ต้นสังกัด, เร่งด่วน, ใบเสร็จ, สถานกงสุล ปรากฏซ้ำใน input เดิม บันทึกการตรวจครั้งแรกระบุ candidate รวม 253 ตำแหน่ง ซึ่งไม่ใช่จำนวนจุดที่ยืนยันว่าตัดบรรทัดผิด หรือจำนวนปัจจุบันของบทความเรื่อง typography นี้
จึงเปลี่ยนคำถามจาก “ลบ CSS แล้วแก้กรณีที่รายงานได้ไหม” เป็น “ขอบเขตไหนอาจอ่านไม่สะดวกเมื่อตัดบรรทัดจริง” Intl.Segmenter แบบ word รายงานการแบ่งคำ ไม่ใช่ตำแหน่งตัดบรรทัดที่ render แล้ว ICU แยก word boundary iterator กับ line boundary iterator และผลยังขึ้นกับ implementation และรุ่นข้อมูล การเทียบ tokenizer ช่วยหา candidate แต่ต้องตรวจ layout จริงในความกว้างที่เกี่ยวข้องอีกขั้น
ไปหา “ความจริง” จาก Thai word tokenizer
แผนเดิมคือใช้ tokenizer อีกตัวเป็น “ground truth” แล้วเทียบกับ Intl.Segmenter แต่คำนี้แรงเกินไป: tokenizer ให้นโยบายแบ่งคำอีกแบบ ไม่ใช่คำตอบตายตัวว่าควรตัดบรรทัดตรงไหน
ตารางนี้จับเวลาที่แต่ละ tokenizer ใช้แบ่งคำในข้อความชุดเดียวกัน คือบทความทุนยาว 47,003 ตัวอักษร (code point) บน Apple M3 Max เมื่อ 5 ตุลาคม 2026 แต่ละค่าเป็น median ของการรัน 30 ครั้งหลัง warm-up ไม่รวมเวลาโหลด ควรเทียบเวลาเฉพาะใน runtime เดียวกัน เพราะ browser, Node.js และ Python เป็นสภาพแวดล้อมต่างกัน ส่วนการวิเคราะห์ 35,436 ตัวอักษรก่อนหน้านี้ใช้ข้อความคนละชุด
| Tokenizer | รันใน | ประเภท | เวลา (ms) |
|---|---|---|---|
Intl.Segmenter |
Browser (Chromium 149) | Built-in | 2.40 |
Intl.Segmenter |
Node.js 25 | Built-in | 3.10 |
| NewMM TypeScript แบบ safe | Node.js 25 | Dictionary | 11.72 |
| NewMM TypeScript | Node.js 25 | Dictionary | 12.87 |
| wordcut | Node.js 25 | Dictionary | 85.83 |
PyThaiNLP newmm-safe |
Python 3.14 | Dictionary | 42.06 |
PyThaiNLP newmm (ค่าเริ่มต้น) |
Python 3.14 | Dictionary | 55.32 |
PyThaiNLP attacut |
Python 3.12 | Neural model | 274.53 |
PyThaiNLP deepcut |
Python 3.12 | Neural model | 2,079.91 |
ทำไม Intl.Segmenter มีสองแถว: เป็น API ในตัวตัวเดียวกัน แต่จับเวลาสองที่ คือใน browser และใน Node.js และแบ่งข้อความได้ไม่เท่ากันด้วย Chromium ได้ 14,707 ชิ้น ส่วน Node.js ได้ 14,649 ชิ้น
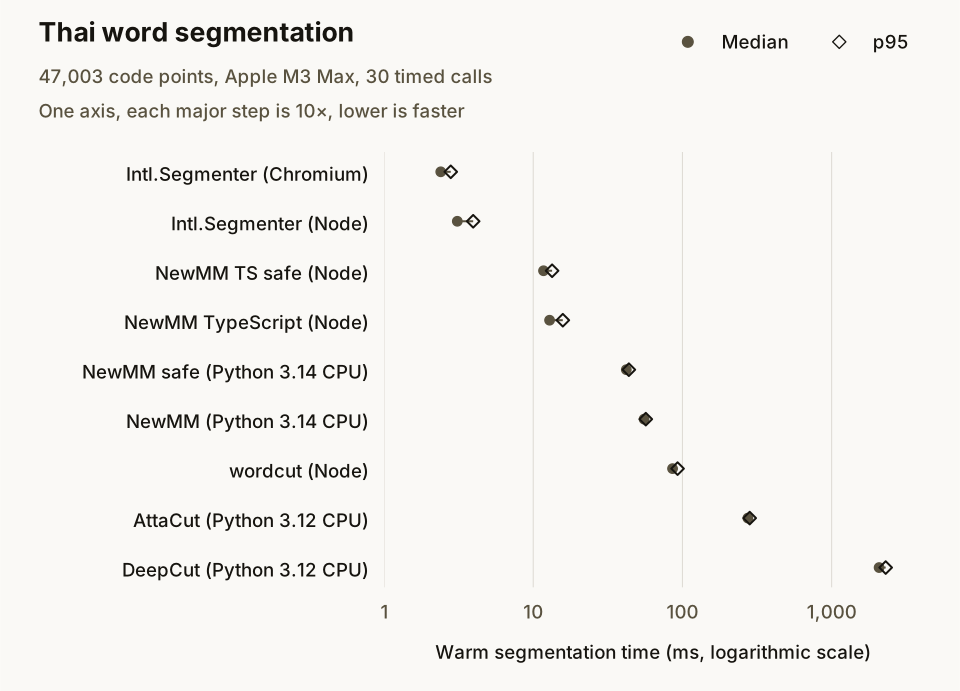
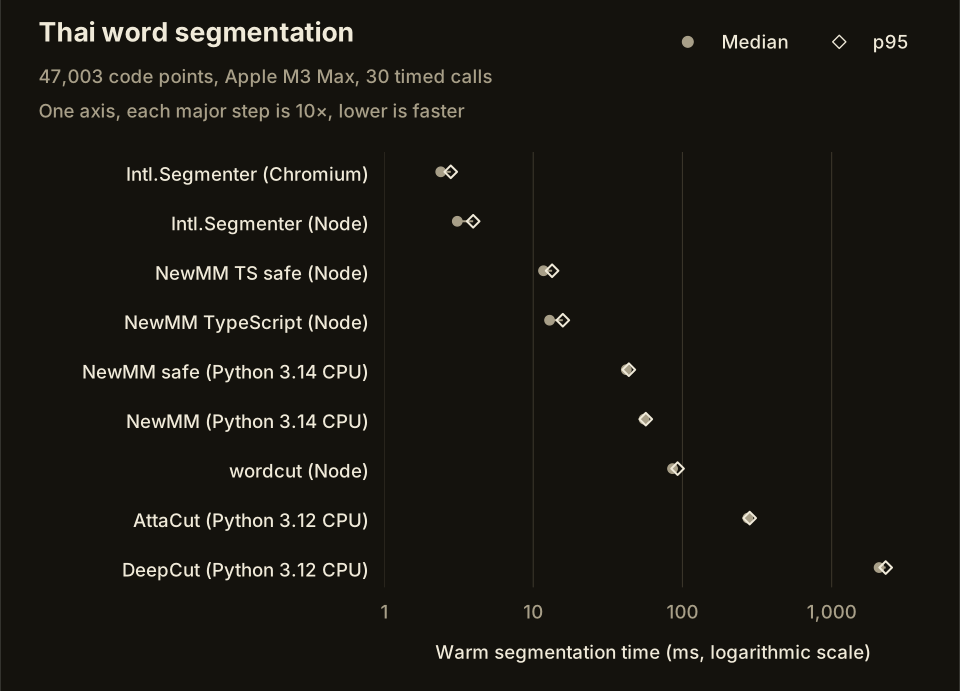
สภาพแวดล้อมและข้อมูล benchmark ดิบ
รายละเอียดแต่ละ engine:
- NewMM TypeScript (
nlpo3-newmm-typescript1.1.0) ดัดแปลง NewMM ของ nlpO3 ถ้าใช้ใน browser ต้อง fetch dictionary แยก (~314KB gzip ในการทดลองเดิม) แล้วโหลดด้วยfromWordList()แบบ safe จะแบ่งข้อความยาวเป็น chunk - wordcut 0.9.1 เป็นแบบ dictionary (~105KB gzip ในการทดลองเดิม) ถ้าใช้ใน browser ต้องปรับการโหลด dictionary ผ่าน
fs/glob - PyThaiNLP
newmmเป็น maximum matching แบบ dictionary พร้อมข้อจำกัด Thai Character Cluster และเป็น engine เริ่มต้นของ PyThaiNLP ส่วนnewmm-safeเลี่ยงงานหนักในข้อความกำกวม - AttaCut ใช้ model เริ่มต้น
attacut-scบน PyTorch ส่วน DeepCut ใช้ CNN weights ที่มากับ package บน TensorFlow ไม่ได้ทดสอบ browser port - เวลา p95 อยู่ในกราฟและรายงานดิบ
ทุก engine ได้ string เดียวกันรวมช่องว่าง: 47,003 Unicode code point / 123,848 byte ใน UTF-8 บน Apple M3 Max (macOS, arm64) warm-up ห้าครั้งแล้วจับเวลา 30 ครั้งต่อ engine คำนวณ p95 แบบ nearest rank รอบเดิมใช้ Node 25.8.2 / ICU 78.3, Python 3.14.3, TypeScript NewMM 1.1.0, wordcut 0.9.1 และ PyThaiNLP 5.3.8
รอบ neural ที่เพิ่มใช้ PyThaiNLP 5.3.8 กับ Python 3.12.13, AttaCut 1.0.6 (attacut-sc, PyTorch 2.14.1, ค่าเริ่มต้น 12 intra-op threads) และ DeepCut 0.7.0.0 (cnn_without_ne_ab.h5 ที่มากับ package, TensorFlow 2.16.2, tf-keras 2.16.0 ใน legacy Keras mode) ทั้งคู่รันบน CPU โหลด model ก่อนจับเวลาการแบ่งคำครั้งแรก ใช้ค่า framework เริ่มต้น รวมถึง batch และ verbosity เริ่มต้นของ DeepCut การตั้งค่าเหล่านี้เป็นส่วนหนึ่งของผลวัด ไม่ใช่ความเร็วสากลของ engine
รอบ browser ใช้ headless Chromium 149.0.7827.55, locale th และการแบ่งแบบ word ของ native Intl.Segmenter ใน browser context ใหม่ รายงานดิบยังมีผลของ ICU/WASM ที่วัดในรอบเดียวกัน แต่ไม่ได้นำมาแสดงในบทความนี้
| Engine / runtime ที่เพิ่ม | Import หรือ browser setup (ms) | โหลด model (ms) | แบ่งคำครั้งแรก (ms) |
|---|---|---|---|
| AttaCut / Python CPU | 7,111.40 | 9.59 | 305.09 |
| DeepCut / Python CPU | 26,477.13 | 136.64 | 5,876.25 |
Native Intl.Segmenter / Chromium |
5.70 | — | 6.50 |
ค่าเริ่มต้นเหล่านี้ วัดครั้งเดียว และขึ้นกับ cache ของ OS/library/browser ไม่ใช่ค่าเฉลี่ย cold start เวลา warm รวมการแบ่งคำและสร้าง list ครบ ไม่รวมติดตั้ง ดาวน์โหลด เริ่ม process ดึง input หรือ render รายงานดิบ มีทุกตัวอย่าง จำนวน token, SHA-256 ของ input, การตั้งค่า และ setup/first call แยก สคริปต์คือ scripts/benchmark-thai-segmentation.mjs, scripts/benchmark-thai-neural.py และ scripts/benchmark-thai-browser.mjs โดย framework และ Playwright ติดตั้งแยกจาก dependency ของเว็บ
เร็วกว่าไม่ได้แปลว่าตัดบรรทัดดีกว่า ตัวเลขนี้วัดบนคอมพิวเตอร์ desktop เครื่องเดียว ไม่ใช่มือถือ และวัดการแบ่งคำ ไม่ใช่ตำแหน่งตัดบรรทัดจริง engine แบบ neural กับแบบ dictionary ยังรันบน Python และ framework ต่างรุ่นกัน ความต่างของเวลาจึงไม่ได้มาจาก algorithm อย่างเดียว
PyThaiNLP ไม่ได้มีเฉพาะ deep learning เอกสารของโครงการ ระบุ engine แบบ dictionary เช่น newmm ซึ่งเป็นค่าเริ่มต้น, longest และ mm ควบคู่กับ neural engine ส่วน newmm-safe เพิ่มกลไกเลี่ยงการประมวลผลนานเมื่อข้อความมีจุดแบ่งกำกวมต่อเนื่อง การเลือก attacut หรือ deepcut เป็นทางเลือกของ engine ไม่ใช่ข้อบังคับในการใช้ PyThaiNLP
workflow เดิมที่ใช้ wordcut ให้ผลมีปัญหารอบ “สหรัฐฯ” แต่ยังไม่มี minimal reproduction ที่เก็บไว้และแยกขั้นตอนดึงข้อความออกจากการ tokenize จึงไม่ควรสรุปว่าเป็นบั๊กของ wordcut ทุกกรณี ส่วน README ของ package TypeScript ที่ติดตั้งกล่าวถึงการใช้ AI ช่วยพัฒนา ข้อความนั้นอย่างเดียวไม่ได้พิสูจน์คุณภาพหรือที่มาของโค้ดทุกบรรทัด ควรประเมินจาก tests, การดูแล, edge cases และผลบน input ที่ต้องการใช้จริงด้วย
สิ่งที่พบระหว่างทาง
บันทึกการทดลอง wordcut เดิมระบุ init ~88ms โดย ~71ms ถูกแยกเป็นงาน CPU และเวลาตัดคำอีก ~61–76ms ตัวเลขนี้เป็นของเครื่องและ input ครั้งนั้น การฝังข้อมูลไว้ใน bundle ลดการโหลดผ่าน network ได้ แต่ไม่ได้ทำให้งาน parse หรือสร้าง trie หายไป ส่วน 300–500ms บนมือถือเป็นการประมาณ ไม่ใช่ผลวัดจากมือถือจริง ต้อง profile อุปกรณ์จริงก่อนสรุปว่าจะทำให้ main thread กระตุกจนผู้อ่านรู้สึกได้
สิ่งที่คาดไม่ถึง: เปลี่ยน ground truth แล้วคำตอบเปลี่ยนไป 6 เท่า
เมื่อเปลี่ยนตัวเปรียบเทียบจาก wordcut เป็น nlpo3-newmm-typescript บันทึกเดิมได้ candidate mismatch 431 รายการ เทียบกับ 70 รายการ หรือประมาณ 6 เท่า ตัวเลขนี้เป็นของ input และรุ่น tokenizer ครั้งนั้น ไม่ใช่จำนวนข้อผิดพลาดในการตัดบรรทัดที่ยืนยันแล้ว
พอไล่ดูรายการจริงถึงเข้าใจว่าทำไม: คำอย่าง เพื่อให้ (in order to), ไม่ต้อง (don’t need to), อยู่แล้ว (already) ถูก dictionary ของ nlpo3-newmm-typescript นับเป็น “คำเดียว” ทั้งที่จริงๆ มันคือคำสองคำธรรมดาที่ต่อกันตามหลักไวยากรณ์ ผู้อ่านทั่วไปไม่รู้สึกแปลกอะไรเลยถ้าเห็นคำพวกนี้ถูกตัดขึ้นบรรทัดใหม่ (เหมือนคนอ่านภาษาอังกฤษไม่รู้สึกแปลกถ้า “in order to” ถูกตัดกลางวลี) นี่ไม่ใช่ปัญหาแบบเดียวกับ “ตัวเอง” ที่ตัดแล้วดูแปลกตาเพราะเป็นหน่วยคำที่แนบแน่นในการอ่านจริง
ข้อสรุปที่สำคัญที่สุดของบทความนี้
Tokenizer แต่ละตัวอาจแบ่ง token ไม่เหมือนกัน เพราะ dictionary, algorithm และการจัดการบริบทต่างกัน คำประสมหรือวลีที่พบบ่อยจึงอาจถูกรวมต่างกัน การไม่ตรงกันไม่ได้แปลว่าฝ่ายหนึ่งผิดเสมอ และ token สำหรับ NLP ก็ไม่จำเป็นต้องเป็นหน่วยที่ควรอยู่ด้วยกันทั้งหน่วยบนบรรทัด สำหรับงานนี้ การตรวจด้วยมือและดูผล render มีประโยชน์กว่าการถือ tokenizer ตัวใดเป็น ground truth ที่ไม่ผิดพลาด
แล้ว “e-reader” จัดการเรื่องนี้ยังไง?
ผมสำรวจรายงานของ e-reader เพิ่มเติม แหล่งข้อมูลเหล่านี้แสดงข้อจำกัดของ implementation บางตัว ไม่ได้พิสูจน์ว่า e-reader ทุกตัวมีปัญหาเดียวกัน หรือไม่มีใครทำ layout ภาษาไทยได้ดี
KOReader: issue #11701 ที่เปิดในปี 2024 รายงานข้อจำกัดการตัดบรรทัดภาษากลุ่มเอเชียตะวันออกเฉียงใต้เมื่อใช้ libunibreak ปัจจุบัน ปิดเป็น “not planned” ผู้รายงานเสนอ ICU4C, libthai, การแทรก zero-width space ก่อนอ่าน และการขยาย libunibreak คำอธิบาย issue กล่าวถึงขนาดและความยากในการ build เป็น trade-off ที่อาจเกิดขึ้น แต่ไม่ได้ยืนยันว่าทีมพัฒนาประเมินครบทุกวิธีหรือปิดเรื่องนี้เพราะขนาด executable โดยเฉพาะ นี่เป็นข้อจำกัดที่เกี่ยวข้องกับ line breaking ไม่ใช่หลักฐานว่าเกิดจาก CSS แบบเดียวกับกรณี WebKit ของผม
Kindle: ผมพบรายงานจากผู้ใช้เรื่องเครื่องหมายไทยเคลื่อนหรือหาย แต่หากไม่มีไฟล์ที่ reproduce ได้ รุ่นเครื่อง/firmware และการวิเคราะห์จากแหล่งหลัก ก็ไม่ควรเหมารวมว่า firmware ปัจจุบันทุกตัวเป็นเช่นนั้น หรือใช้จัดอันดับว่าแย่กว่า KOReader
ไม้ยมก (ๆ): Thai Gap Analysis ของ W3C รายงาน test ที่ Gecko, Blink และ WebKit ปล่อยให้ไม้ยมกขึ้นต้นบรรทัด รวมถึงกรณีมีช่องว่างก่อนหน้า ทั้งที่ควรให้อยู่กับข้อความก่อนหน้า นี่เป็นผลทดสอบที่มีบันทึก ไม่ใช่ผลทดสอบใหม่ของ browser ทุกรุ่นที่ใช้งานอยู่ตอนนี้
แล้วภาษาอื่นที่ “ไม่มีช่องว่างระหว่างคำ” เหมือนไทยล่ะ?
ขยายการสำรวจออกไปอีกขั้น ภาษา/ตัวอักษรที่เขียนติดกันไม่มีช่องว่าง (scriptio continua) ไม่ได้มีแค่ไทย และที่น่าสนใจคือ ไม่ใช่ทุกภาษาที่เขียนติดกันจะเจอปัญหาแบบเดียวกัน
ภาษาลาว เขมร และพม่า ต้องใช้การจัดการ segmentation และ layout ตามภาษาเช่นกัน แต่ไม่ได้หมายความว่ากฎหรือสาเหตุของปัญหาเหมือนไทยทุกอย่าง การหารือของ W3C เรื่อง เขมร และ ลาว ถามเรื่องขอบเขตคำกับพยางค์และขอตัวอย่างปัญหาที่เกิดจริง จึงเป็นหลักฐานว่ามีประเด็นที่กำลังศึกษา ไม่ใช่ข้อสรุปว่าการตัดบรรทัดของภาษาเหล่านี้ไม่มีข้อกำหนดใดเลย
ภาษาพม่ายังมีเรื่องความเข้ากันได้ของ encoding แยกต่างหาก: ข้อความ Zawgyi แบบเก่ากับ Unicode Myanmar ใช้แทนกันโดยตรงไม่ได้ การเปลี่ยน font อย่างเดียวไม่ใช่การแปลงข้อมูลที่เชื่อถือได้ เรื่องนี้เกี่ยวกับ encoding และ shaping จึงควรแยกจากการเลือกตำแหน่งตัดบรรทัด
ภาษาทิเบตมีเครื่องหมายแบ่งพยางค์โดยตรง tsheg (་, U+0F0B) ช่วยกำหนดจุดตัดบรรทัดทั่วไปโดยไม่ต้องหา boundary แบบ dictionary ไทยทุกจุด แต่ไม่ได้หมายความว่าตัดหลัง tsheg ได้ทุกครั้ง ข้อกำหนด layout ทิเบตของ W3C ระบุข้อยกเว้น เช่น ชุด NGA–tsheg–shad และความต้องการหลีกเลี่ยงการตัดกลางคำหลายพยางค์บางกรณี ส่วน U+0F0C เป็น tsheg แบบไม่ตัดบรรทัดสำหรับบริบทเฉพาะ ประเด็นเปรียบเทียบคือเครื่องหมายแบ่งช่วยลดความยากบางส่วน ไม่ได้ทำให้กฎ layout ทั้งหมดหมดไป
ภาษาจีนและญี่ปุ่นโดยทั่วไปตัดบรรทัดระหว่างอักขระได้ แต่มีข้อจำกัดรอบเครื่องหมายวรรคตอน kana ตัวเล็ก และลำดับอักขระบางแบบ กฎ kinsoku ของญี่ปุ่นมีรายละเอียดใน Japanese Layout Requirements ของ W3C อักขระทุกตัวไม่ได้เป็นคำที่มีความหมายสมบูรณ์แยกเดี่ยว และไม่ใช่ทุก boundary ที่ตัดได้ ประเด็นที่ต่างจากไทยคือวิธีกำหนดจุดตัด ไม่ใช่การที่ภาษาใดภาษาเดียวแก้ปัญหา layout เสร็จสมบูรณ์แล้ว
สิ่งที่เว็บนี้ใช้งานจริงตอนนี้
- ลบ override
word-break: keep-allสำหรับภาษาไทย ช่วยกรณีที่ทดสอบเดิมโดยไม่เพิ่ม tokenizer ให้เนื้อหาบทความ แต่ไม่รับประกันการ wrap ไทยทุกข้อความ - รายการที่ตรวจด้วยมือปัจจุบันมี 71 รายการ อยู่ใน
src/data/thai-word-joins.jsonเป็นหน่วยที่เลือกไว้สาธิตการให้อยู่ด้วยกัน ไม่ใช่รายการบั๊ก browser ที่ใช้ได้สากล demo ใช้รายการนี้ แต่เนื้อหาบทความไม่ได้ถูก postprocess ด้วยรายการดังกล่าว - มี postbuild script ให้เรียกเอง:
scripts/apply-thai-word-joins.mjsห่อคำที่ตรงรายการด้วยwhite-space:nowrapใน.markdown-body[lang="th"]ของ HTML ที่ build แล้ว โดยข้ามโค้ด ลิงก์ หัวข้อ และส่วนอื่นที่ยกเว้นไว้ สคริปต์นี้ ไม่ได้อยู่ในnpm run buildจำนวน match ขึ้นกับบทความและรายการปัจจุบัน จึงไม่ควรใช้ 253 เป็นผลปัจจุบันของบทความนี้ สคริปต์ยังจับ grapheme ก่อนๆให้อยู่ด้วยกัน แต่กรณี grapheme นั้นเป็นช่องว่างยังไม่ได้แก้กฎไม้ยมกแบบเว้นวรรคครบถ้วน - demo โหลด asset ของ tokenizer เพิ่มเฉพาะเมื่อเลือก tab นั้น สามโหมดแรกกับ native
Intl.Segmenterไม่ต้องดาวน์โหลด dictionary เต็มชุด ส่วน NewMM และ wordcut โหลด asset ตามคำขอ การอยู่ในdevDependenciesไม่ได้ป้องกัน import ฝั่ง browser จากการถูก bundle และส่งให้ผู้อ่าน npm run thai:auditเป็นเครื่องมือหา candidate ระหว่างพัฒนา เทียบ tokenizer TypeScript กับIntl.Segmenterบนบทความไทยที่ build แล้ว ไม่แก้รายการอัตโนมัติ ผลต้องตรวจด้วยมือและดู render อีกครั้ง จำนวน candidate เปลี่ยนตาม input และรุ่นซอฟต์แวร์
โหมด curated ใช้ CSS no-wrap span ไม่ได้แทรกอักขระ U+2060 WORD JOINER และเป็นเพียงการสาธิต ไม่ใช่การแก้ที่ใช้กับเนื้อหารอบ demo อยู่แล้ว เรายังเลือกไม่ใช้ full tokenizer หรือ automatic justification กับทุกบทความ หากยังไม่มีหลักฐานว่าจะทำให้อ่านดีขึ้น
ลองเล่นเองได้เลย
พิมพ์ข้อความของคุณเองหรือใช้ตัวอย่างไทยที่ยาวขึ้นเป็นสามย่อหน้า เริ่มจากการเตรียมเอกสารสถานทูต ต่อด้วยสถานการณ์สมมติเรื่องสมัครมหาวิทยาลัย และการเปรียบเทียบการอ่านที่มีทั้งคำอังกฤษ วันที่ สกุลเงิน ทศนิยม คำย่อ และไม้ยมก เพื่อให้เห็นความต่างของนโยบายแบ่งคำบนข้อความยาวจริง
สาม tab แรกแสดงการจำลอง break-all, ค่า wrap เริ่มต้นของ browser และ curated no-wrap span โหมดจำลองไม่ใช่การ replay พฤติกรรม WebKit เดิมตรงๆ ส่วน tab ที่เหลือแบ่งคำจริงด้วย Intl.Segmenter ของ browser, TypeScript NewMM แบบปกติหรือ safe mode และ wordcut 0.9.1 ที่ปรับการโหลดสำหรับ browser แต่ละ token ถูกห่อด้วย no-wrap span เพื่อเปรียบเทียบ ซึ่ง ไม่ใช่ algorithm ตัดบรรทัดของ tokenizer โหมด browser wrapping จึงแยกต่างหาก
NewMM และ wordcut โหลด dictionary เมื่อเลือกใช้ ทุก tokenizer แสดงผลหนึ่งบรรทัดเรียงแบบเดียวกัน คือได้กี่ชิ้น ใช้เวลาเท่าไร และแบ่งต่างจาก Intl.Segmenter ของ browser กี่จุด จุดที่ต่างจะไฮไลต์ไว้ในข้อความ และรายการใต้บรรทัดนั้นแสดงแต่ละแบบที่แบ่งต่างกันเทียบกันให้เห็น ความต่างไม่ใช่คะแนนคุณภาพ และผลที่ตรงกันก็เป็นเรื่องปกติ เครื่องหมายจุดแบ่งคำปิดไว้ตั้งแต่ต้นเพราะเพิ่มระยะห่าง เปิดเมื่ออยากเห็นแต่ละชิ้น ทุกข้อความประมวลผลใน browser ของคุณ ส่วน engine Python ของ PyThaiNLP อยู่ในตาราง benchmark แต่ไม่ได้รันใน demo ของเว็บ static นี้
แหล่งข้อมูลอ้างอิง
- CSS Text: word-break (W3C)
- ICU Boundary Analysis: word and line iterators
- PyThaiNLP tokenizer engines
- Requirements for Japanese Text Layout (W3C)
- Thai Layout Requirements (W3C, 2024)
- Thai Gap Analysis (W3C)
- Approaches to line breaking (W3C Internationalization)
- Khmer line-breaking: open issue (W3C sealreq)
- Lao line-breaking: open issue (W3C sealreq)
- KOReader issue #11701: Thai language word break doesn’t work
- Tibetan formatting rules: Digital Tibetan
- Requirements for Tibetan Text Layout and Typography (W3C, 2024)
- wordcut (npm)
- nlpo3-newmm-typescript (npm)
- nlpO3 by PyThaiNLP
ความคิดเห็น
กำลังโหลดความคิดเห็น…
โหมดผู้เขียน: ตอบกลับในนามผู้เขียน